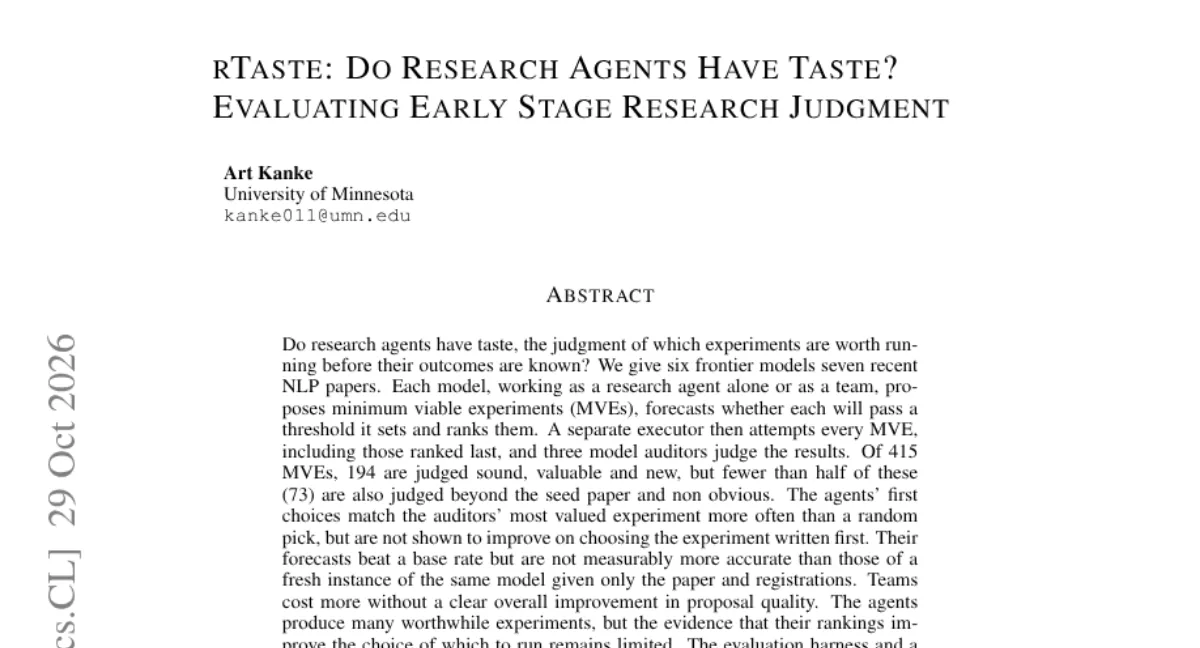
中文 用途:rTaste 是一个评测研究型 Agent 是否具备「品味」的基准,让模型在实验尚未有结果时判断哪些实验值得做,适用于评估前沿模型的研究判断力。
能做什么
- 给出六款前沿模型与七篇近期 NLP 论文,要求模型以研究 Agent 身份独立或协作完成任务。
- 评测重点不是最终实验成败,而是模型在结果未知前对实验价值的早期判断。
- 支持单 Agent 与多 Agent 两种工作模式,用于对比不同协作结构下的判断表现。
适用场景:适合研究 AI Agent 评测、科研自动化或模型判断力的团队,需要能调用前沿模型 API 并具备 NLP 论文阅读与实验设计背景。
日本語 用途:rTaste は、研究エージェントに「センス」があるかを測るベンチマークです。結果が出る前にどの実験が価値あるかを判断させ、フロンティアモデルの研究判断力を評価します。
できること
- 6 つのフロンティアモデルと最近の NLP 論文 7 本を組み合わせ、モデルを研究エージェントとして動かす。
- 単独エージェントと複数エージェントの 2 形態を用意し、協働構造による判断の違いを比較できる。
- 評価の焦点は実験の成否ではなく、結果未知の段階での実験価値の見極めに置く。
利用シーン:AI エージェントの評価や研究自動化に関心のあるチーム向け。フロンティアモデルの API 利用と NLP 論文の読解・実験設計の素養が前提です。
한국어 용도: rTaste는 연구 에이전트의 ‘취향’을 평가하는 벤치마크로, 실험 결과가 나오기 전 어떤 실험이 가치 있는지 판단하게 하여 프런티어 모델의 연구 판단력을 측정합니다.
할 수 있는 것
- 6개 프런티어 모델과 최근 NLP 논문 7편을 결합해 모델을 연구 에이전트로 실행한다.
- 단일 에이전트와 다중 에이전트 두 방식을 제공해 협업 구조에 따른 판단 차이를 비교한다.
- 평가의 초점은 실험 성패가 아니라 결과를 모르는 단계에서의 실험 가치 판단에 둔다.
적용 상황: AI 에이전트 평가나 연구 자동화에 관심 있는 팀에 적합합니다. 프런티어 모델 API 사용과 NLP 논문 독해, 실험 설계 배경이 필요합니다.
English What it is: rTaste is a benchmark for whether research agents have taste, the judgment of which experiments are worth running before outcomes are known, tested with six frontier models and seven recent NLP papers.
Key capabilities
- Runs six frontier models as research agents over seven recent NLP papers, alone or in collaboration.
- Compares single-agent and multi-agent setups to see how collaboration changes early research judgment.
- Focuses evaluation on pre-outcome judgment of experiment value rather than final experiment success.
Who it is for: Teams studying AI agent evaluation or research automation, with access to frontier model APIs and background in reading NLP papers and designing experiments.