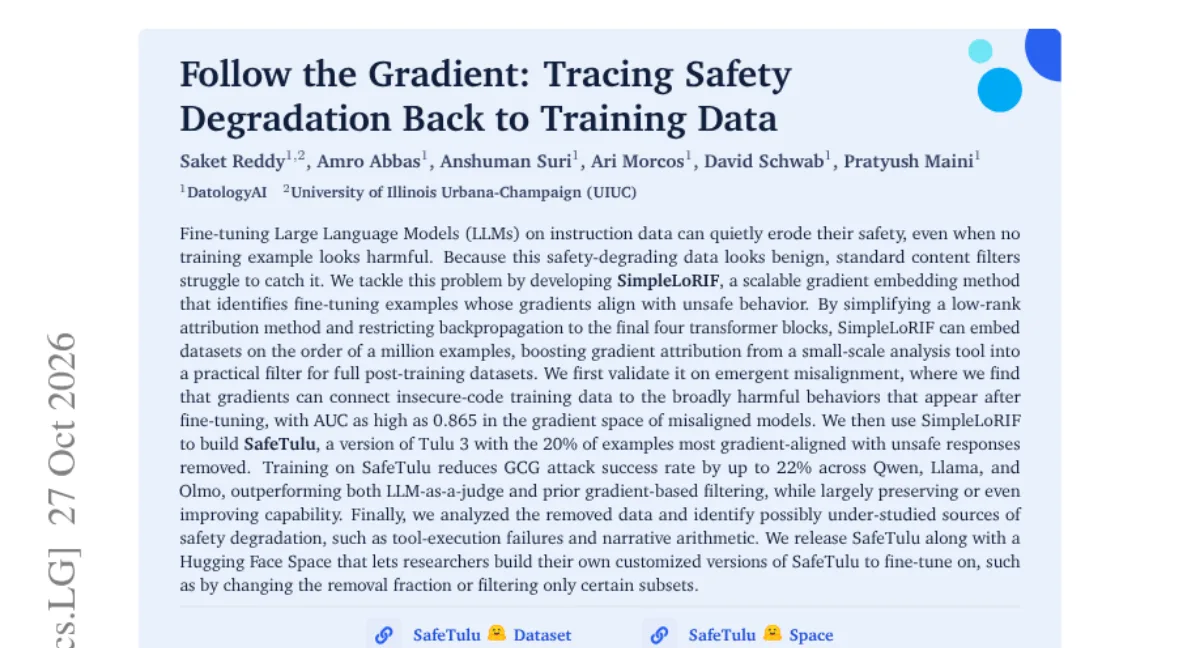
中文 用途:这条内容介绍一种用梯度追踪微调数据与安全退化之间关联的方法,帮助研究者和工程师定位哪些看似无害的训练样本在悄悄削弱模型的安全对齐。
能做什么
- 指出指令微调即使不含明显有害样本,也会让模型安全性下降,常规内容过滤难以察觉。
- 通过梯度信号把安全退化回溯到具体训练数据,而非只停留在整体评测指标层面。
- 面向数据筛选环节,为清洗或重加权训练集提供可核对的依据。
适用场景:适合做 LLM 安全对齐、微调数据治理的研究人员与工程师,需要具备模型训练和梯度分析经验,并能访问训练数据与模型权重。
日本語 用途:指示データで LLM をファインチューニングすると安全特性が静かに損なわれる問題について、勾配情報から原因となる学習データを特定する手法を解説する内容です。
できること
- 有害に見えない指示データでも、ファインチューニング後にモデルの安全性が低下することを示す。
- 通常のコンテンツフィルタでは検出しにくい、安全劣化を引き起こすデータの性質に着目する。
- 勾配シグナルを手がかりに、安全性の低下を具体的な学習サンプルへと遡って特定する。
想定される利用場面:LLM の安全アラインメントや微調整データの管理に携わる研究者・エンジニア向け。モデル学習と勾配分析の経験があり、学習データとモデルの重みにアクセスできることが前提です。
한국어 용도:명령 데이터로 LLM을 파인튜닝할 때 안전성이 조용히 약화되는 문제를 다루며, 그래디언트 신호로 원인이 되는 학습 데이터를 추적하는 방법을 설명하는 내용입니다.
할 수 있는 것
- 유해해 보이지 않는 명령 데이터도 파인튜닝 후 모델의 안전성을 떨어뜨릴 수 있음을 보여준다.
- 일반적인 콘텐츠 필터로는 걸러내기 어려운 안전성 저하 데이터의 성질을 짚는다.
- 그래디언트 신호를 근거로 안전성 저하를 구체적인 학습 샘플까지 거슬러 추적한다.
적용 상황:LLM 안전 정렬과 파인튜닝 데이터 관리를 하는 연구자와 엔지니어에게 적합합니다. 모델 학습과 그래디언트 분석 경험이 있고 학습 데이터와 모델 가중치에 접근할 수 있어야 합니다.
English What it is: This content explains a gradient-based method for tracing safety degradation in fine-tuned LLMs back to the specific training data responsible, even when no example looks harmful.
Key capabilities
- Shows that instruction fine-tuning can quietly erode model safety without any obviously harmful samples.
- Highlights data properties that standard content filters fail to catch.
- Uses gradient signals to trace a safety drop back to individual training samples rather than aggregate metrics.
Who it is for: Researchers and engineers working on LLM safety alignment or fine-tuning data governance, with experience in model training and gradient analysis and access to training data and weights.