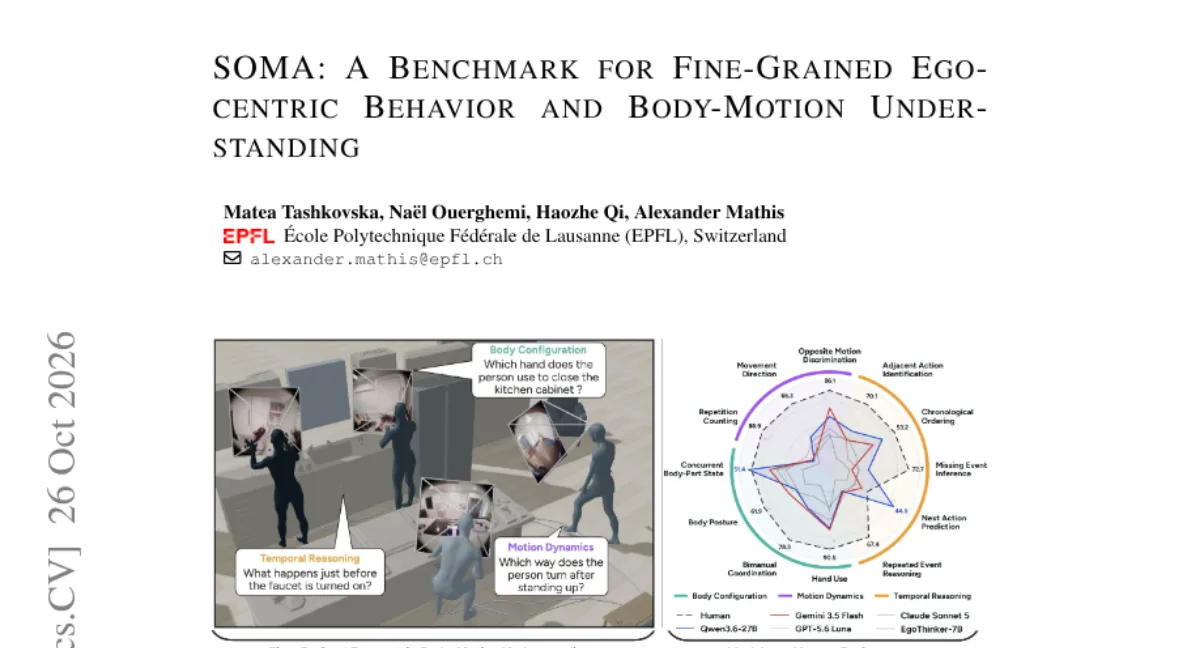
中文 用途:SOMA 是一个评测多模态大模型细粒度自我中心行为与身体动作理解能力的基准,帮助研究者判断模型在人体运动感知上的真实水平。
能做什么
- 聚焦第一人称视角下的身体动作与行为理解,而非物体或场景识别。
- 针对现有 MLLM 评测偏重粗粒度动作的问题,补充细粒度动作判别维度。
- 以基准形式提供统一评测入口,便于横向比较不同模型。
适用场景:适合多模态大模型研究者、具身智能与人体运动分析方向的研究人员,在需要评估模型对第一人称身体动作理解能力时使用。
日本語 用途:SOMA は、マルチモーダル大規模言語モデルの一人称視点における細粒度の行動・身体動作理解を評価するためのベンチマークです。
できること
- 物体やシーン認識ではなく、一人称視点の身体動作と行動理解に焦点を当てる。
- 既存の MLLM 評価が粗い動作に偏る問題を補い、細粒度の動作判別軸を追加する。
- ベンチマーク形式で統一された評価入口を提供し、モデル間の比較を容易にする。
利用シーン:マルチモーダル大規模言語モデルの研究者や、身体性知能・人体動作分析の研究に携わる人が、一人称視点の動作理解能力を評価したい場面で使用します。
한국어 용도:SOMA는 멀티모달 대규모 언어 모델의 1인칭 시점에서의 세밀한 행동 및 신체 동작 이해 능력을 평가하는 벤치마크입니다.
할 수 있는 것
- 객체나 장면 인식이 아닌 1인칭 시점의 신체 동작과 행동 이해에 초점을 둡니다.
- 기존 MLLM 평가가 거친 동작에 치우친 문제를 보완해 세밀한 동작 판별 축을 추가합니다.
- 벤치마크 형태로 통일된 평가 진입점을 제공해 모델 간 비교를 쉽게 합니다.
적용 상황:멀티모달 대규모 언어 모델 연구자나 구현 지능·인체 동작 분석 연구자가 1인칭 시점의 동작 이해 능력을 평가하려는 상황에서 사용합니다.
English What it is: SOMA is a benchmark for evaluating fine-grained egocentric behavior and body-motion understanding in multimodal large language models (MLLMs).
Key capabilities
- Focuses on first-person body motion and behavior understanding rather than object or scene recognition.
- Adds a fine-grained motion discrimination axis to address existing MLLM evaluations that skew toward coarse actions.
- Provides a unified benchmark entry point for comparing different models.
Who it is for: Researchers working on multimodal large language models, embodied intelligence, or human motion analysis who need to assess first-person body-motion understanding.