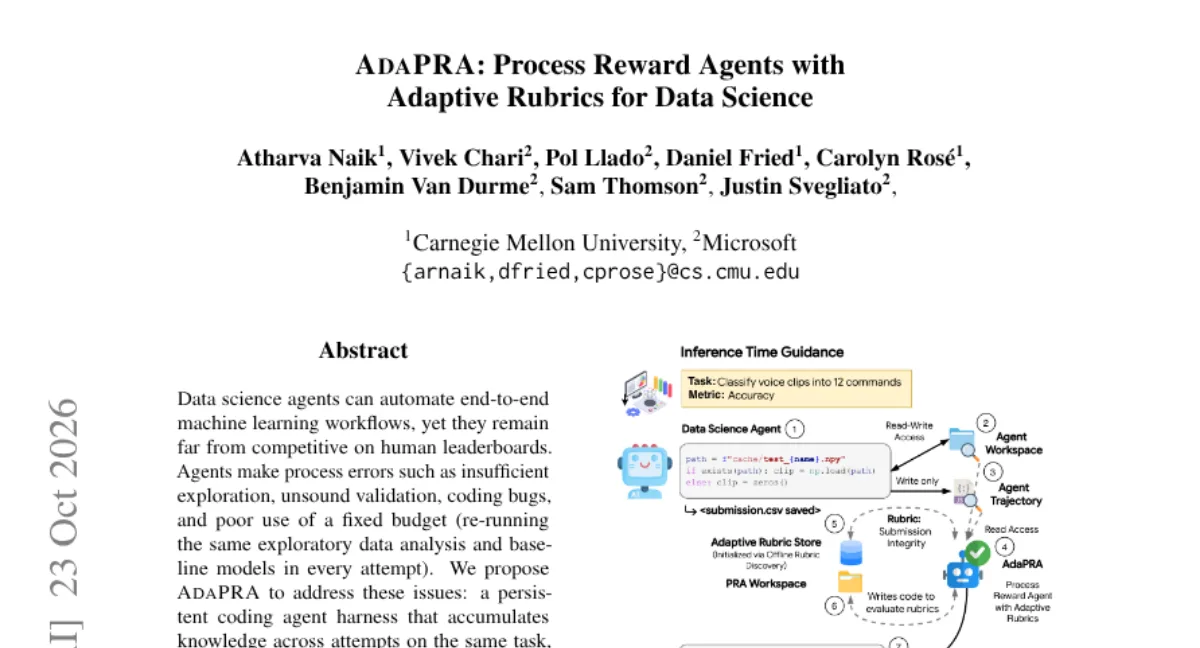
中文 用途:AdaPRA 是一套面向数据科学 Agent 的过程奖励框架,通过自适应评分标准对智能体的中间步骤打分,帮助团队定位并修正探索不足、验证不严谨等流程错误。
能做什么
- 用自适应 rubric 对数据科学任务的中间过程逐步评分,而非只看最终指标。
- 针对探索不充分、验证设计不合理、代码实现缺陷等典型流程错误给出反馈信号。
- 面向端到端机器学习工作流,覆盖从数据理解到建模评估的多个环节。
- 以过程奖励驱动 Agent 改进,缩小与人类排行榜选手的差距。
适用场景:适合正在搭建或调优数据科学 Agent 的研究与工程团队,需要具备 Python 环境和 LLM API 访问权限,用于诊断 Agent 在真实 ML 任务中的过程性失误。
日本語 用途:AdaPRA はデータサイエンス Agent のための中間ステップ評価フレームワークで、適応的なルーブリックを用いて探索不足や検証設計の甘さといったプロセス上の誤りを可視化します。
できること
- 最終スコアだけでなく、ML ワークフローの中間ステップを適応的ルーブリックで採点する。
- 探索不足、検証の妥当性不足、コード上の欠陥など典型的なプロセスエラーに反馈信号を与える。
- データ理解からモデリング・評価までのエンドツーエンドなワークフローを対象とする。
- プロセス報酬によって Agent の振る舞いを改善し、人間のリーダーボードとの差を縮める。
利用シーン:データサイエンス Agent を構築・調整する研究開発チーム向け。Python 実行環境と LLM の API キーが必要で、実タスクでのプロセス上の失敗を診断したい場合に適します。
한국어 용도:AdaPRA는 데이터 사이언스 Agent의 중간 단계를 적응형 루브릭으로 평가해 탐색 부족, 검증 설계 미흡 같은 프로세스 오류를 드러내는 프레임워크입니다.
할 수 있는 것
- 최종 지표만 보지 않고 ML 워크플로의 중간 단계를 적응형 루브릭으로 채점한다.
- 탐색 부족, 검증 타당성 결여, 코드 결함 등 전형적 프로세스 오류에 피드백 신호를 준다.
- 데이터 이해부터 모델링·평가까지 엔드투엔드 워크플로를 대상으로 한다.
- 프로세스 보상으로 Agent 동작을 개선해 인간 리더보드와의 격차를 줄인다.
적용 상황:데이터 사이언스 Agent를 구축하거나 조정하는 연구·엔지니어링 팀에 적합합니다. Python 실행 환경과 LLM API 키가 필요하며, 실제 ML 작업에서의 프로세스 실패를 진단할 때 사용합니다.
English What it is: AdaPRA is a process-reward framework for data science agents that scores intermediate steps with adaptive rubrics, surfacing workflow errors such as weak exploration or unsound validation.
Key capabilities
- Scores intermediate steps of ML workflows with adaptive rubrics rather than relying only on final metrics.
- Provides feedback signals for common process errors including insufficient exploration, poor validation design, and coding defects.
- Targets end-to-end data science workflows spanning data understanding through modeling and evaluation.
- Uses process rewards to improve agent behavior and narrow the gap with human leaderboard entries.
Who it is for: Research and engineering teams building or tuning data science agents, with a Python environment and LLM API access, who need to diagnose process-level failures in real ML tasks.