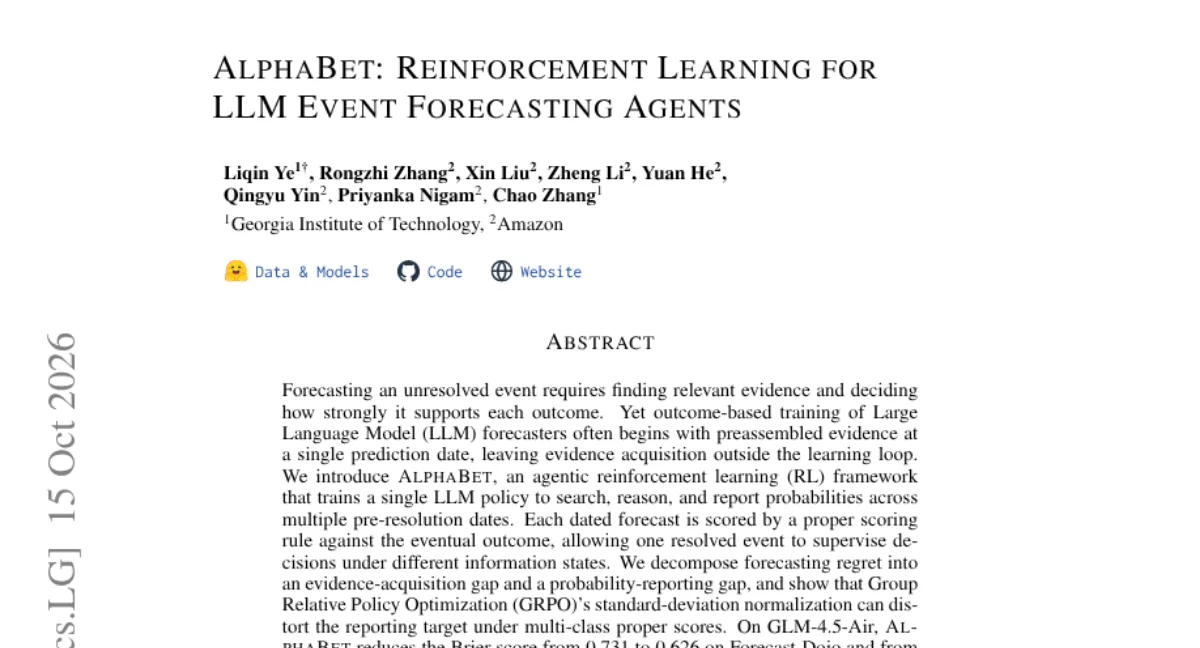
中文 用途:AlphaBet 是一套面向 LLM 事件预测 Agent 的强化学习训练方案,让模型在结果未定的事件上自行检索证据并判断各结果的支持强度,适合研究预测与推理训练的人参考。
能做什么
- 针对结果未定事件,先找相关证据,再决定证据对各结果的支持程度
- 以结果为导向训练 LLM 预测器,训练起点是预先组装好的数据
- 把证据检索与结果判断放进同一套强化学习流程里
- 用结果信号驱动 Agent 调整检索与判断策略
适用场景:做 LLM Agent 强化学习、事件预测或证据推理的研究者与工程师,在已有模型训练环境和评测流程的前提下,用来搭建预测类 Agent 的训练管线。
日本語 用途:AlphaBet は、未解決の出来事を予測する LLM エージェント向けの強化学習トレーニング手法です。モデルが自ら根拠を探し、各結果への支持の強さを判断する流れを扱いたい研究向けです。
できること
- 結果が未確定の事象について、関連する根拠を探したうえで各結果への支持度を決める
- 結果に基づく目的関数で LLM 予測器を訓練する
- 訓練の出発点として、あらかじめ組み立てられたデータを用いる
- 根拠検索と結果判断を同じ強化学習のループに置く
利用場面:LLM エージェントの強化学習、事象予測、根拠に基づく推論を研究する人向け。モデル訓練環境と評価パイプラインが用意されていることが前提です。
한국어 용도:AlphaBet은 미해결 사건을 예측하는 LLM 에이전트를 위한 강화학습 훈련 방식입니다. 모델이 스스로 근거를 찾고 각 결과에 대한 지지 강도를 판단하는 흐름을 다루려는 연구에 쓸 수 있습니다.
할 수 있는 것
- 결과가 정해지지 않은 사건에서 관련 근거를 찾고 각 결과에 대한 지지 정도를 판단한다
- 결과 기반 목표로 LLM 예측기를 훈련한다
- 훈련의 출발점으로 미리 구성된 데이터를 사용한다
- 근거 검색과 결과 판단을 하나의 강화학습 루프에 둔다
적용 상황:LLM 에이전트 강화학습, 사건 예측, 근거 기반 추론을 연구하는 사람에게 적합합니다. 모델 훈련 환경과 평가 파이프라인이 갖춰져 있어야 합니다.
English What it is: AlphaBet is a reinforcement learning training approach for LLM agents that forecast unresolved events. It targets the loop of finding relevant evidence and judging how strongly that evidence supports each outcome, for researchers working on forecasting and evidence-based reasoning.
Key capabilities
- For unresolved events, retrieve relevant evidence first, then decide support strength per outcome
- Train LLM forecasters with outcome-based objectives
- Start training from preassembled data rather than raw streams
- Keep evidence retrieval and outcome judgment inside one RL loop
Who it is for: Researchers and engineers working on LLM agent RL, event forecasting, or evidence-grounded reasoning, with a model training environment and evaluation pipeline already in place.