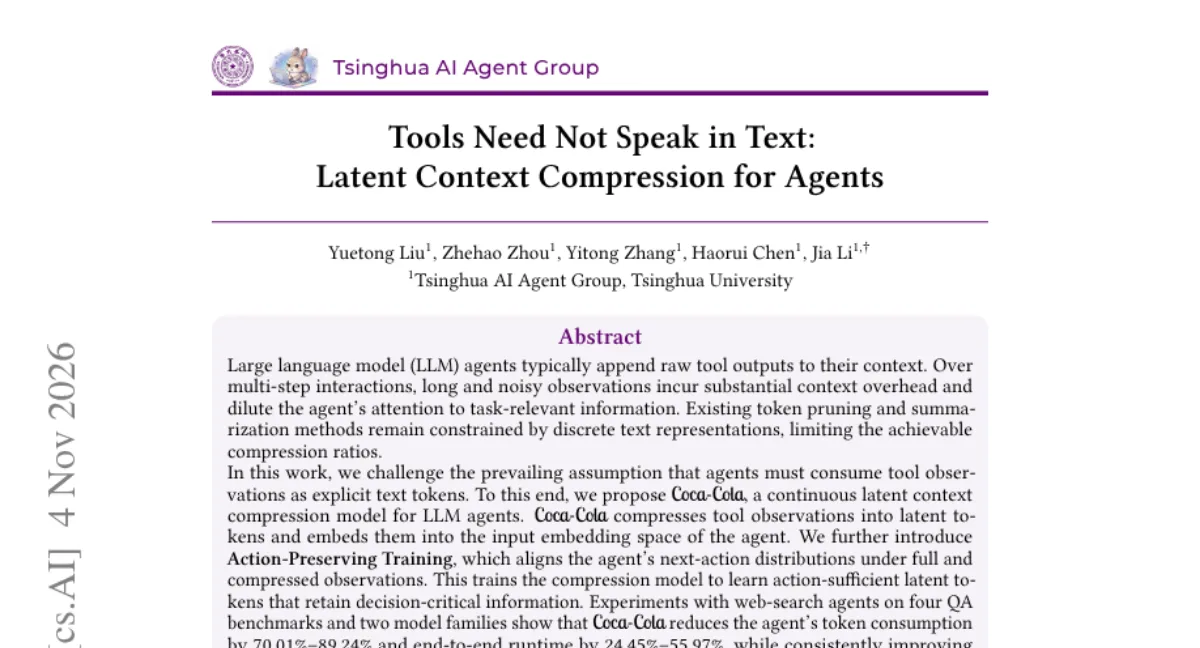
中文 用途:这条内容介绍一种面向 Agent 的潜在上下文压缩方法,让工具返回结果不再以原始文本堆入上下文,从而控制上下文长度,把注意力留给任务本身。
能做什么
- 把工具输出编码为 latent 表示,替代向上下文直接追加原始文本串
- 面向多步交互,对长且嘈杂的 observation 做压缩,抑制上下文持续膨胀
- 目标是降低上下文开销,避免无关内容稀释 Agent 对任务的注意力
- 关注点落在表示形式本身,属于方法层面的探索而非提示词调优
适用场景:适合研究 LLM Agent 上下文管理的人阅读,也适合需要处理大量工具调用返回结果的工程实践者;需了解 Transformer 上下文机制与 Agent 基本流程。
日本語 用途:LLM エージェント向けの潜在コンテキスト圧縮手法を紹介する内容で、ツールの戻り値を生テキストのままコンテキストへ積まなくし、コンテキストの長さを抑えて注意をタスク本体に残せるようにする。
できること
- ツール出力を生のテキスト文字列ではなく latent 表現にエンコードする
- 多段階の対話で長くノイズの多い observation を圧縮し、コンテキストが膨らみ続けるのを抑える
- コンテキストのオーバーヘッドを下げ、無関係な内容にエージェントの注意が薄まるのを防ぐことが狙い
- プロンプト調整ではなく、表現形式そのものに焦点を当てた手法レベルの探求である
向いている人:LLM エージェントのコンテキスト管理を研究する人や、大量のツール呼び出し結果を扱う必要のある実務者。Transformer のコンテキスト機構とエージェントの基本フローを理解していることが前提。
한국어 용도: LLM 에이전트를 위한 잠재 컨텍스트 압축 방법을 소개하는 내용으로, 도구 반환 결과가 원시 텍스트 그대로 컨텍스트에 쌓이지 않게 해 컨텍스트 길이를 통제하고 주의를 과제 자체에 남긴다.
할 수 있는 것
- 도구 출력을 원시 텍스트 문자열 대신 latent 표현으로 인코딩한다
- 여러 단계의 상호작용에서 길고 잡음이 많은 observation을 압축해 컨텍스트가 계속 불어나는 것을 억제한다
- 컨텍스트 오버헤드를 낮춰 무관한 내용이 에이전트의 과제 주의를 희석하지 않게 하는 것이 목표다
- 프롬프트 튜닝이 아닌 표현 형식 자체에 초점을 둔 방법 수준의 탐색이다
대상: LLM 에이전트의 컨텍스트 관리를 연구하는 사람, 대량의 도구 호출 반환 결과를 처리해야 하는 실무자. Transformer 컨텍스트 메커니즘과 에이전트 기본 흐름에 대한 이해가 필요하다.
English Purpose: This note outlines a latent context compression approach for LLM agents, so tool results no longer enter the context as raw text and the model can spend its window and attention on the task itself.
What it does
- Encodes tool outputs as latent representations instead of appending raw text strings
- Targets multi-step interactions where observations grow long and noisy, and context keeps inflating
- Aims to cut context overhead and keep task-relevant attention from being diluted
- A method-level idea about representation rather than prompt tuning
When to use it: Suited to people researching or building LLM agents that call tools repeatedly and need to keep context small; assumes familiarity with Transformer context mechanisms and basic agent workflows.